算法课笔记1
一篇平平无奇的课堂笔记 内容长且无规则
普适思想
- coding style
- 考虑全面各种情况(第一步永远是边界检测)
- bug free
- 交流-思考-渐进的过程
例题:strstr
重点:不要总想着kmp算法,因为它仅仅只是一个算法
第一步库函数(int pos = haystack.find(needle);)
第二步暴力解法 (for循环嵌套)
第三步优化
递归recursion的思想
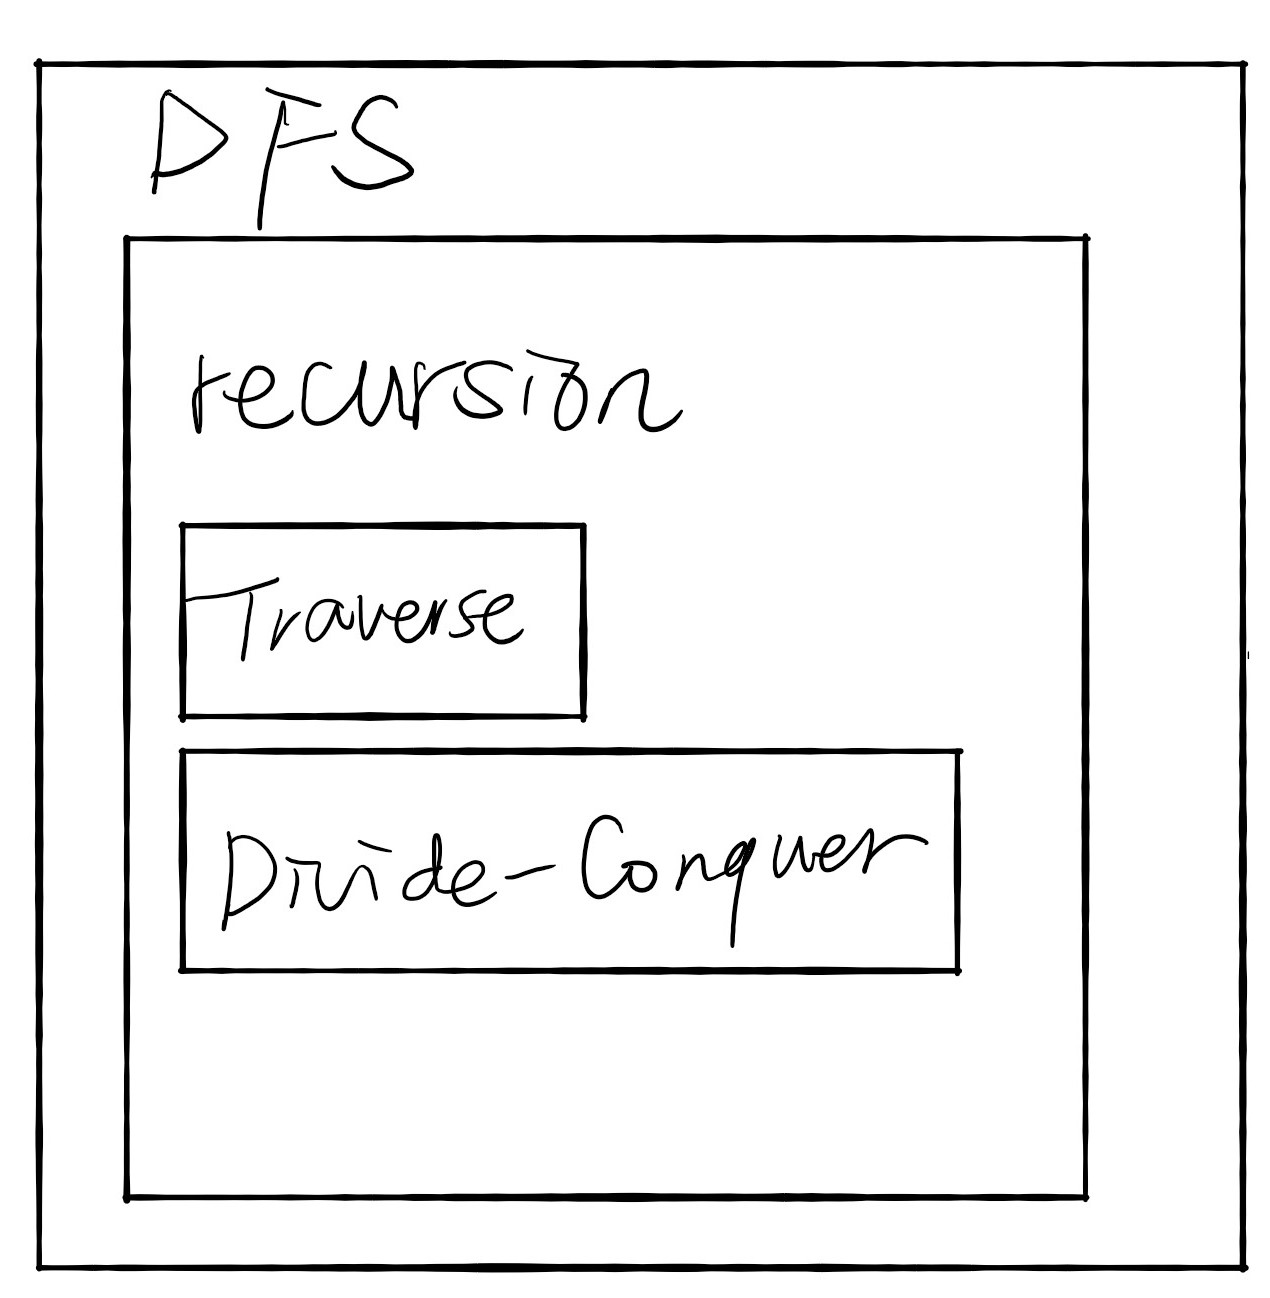
重点:使用深度优先搜索DFS实现递归==使用回溯的思想。
递归的三个要素:
第一步:定义要用递归完成的事情
第二步: 如何将问题变为子问题
第三步: 什么时候退出递归(什么时候给返回值)
使用深度优先搜索的情境or排列组合模板总结:
- 适用范围:几乎所有的搜索问题
- 需要做出的改动:1. 什么时候输出;2. 哪些情况需要跳过
- 试着举例:
- permutations/unique permutations
- combination sum/letter combination of a phone number
- palindrome partitioning
- restore ip address
例题:subsets
两种解法需要掌握:
-
递归实现DFS
void helper(vector<vector<int> >& res, vector<int> tmp, vector<int>& nums, int level) { if (level >= nums.size()) { res.push_back(tmp); return; } tmp.push_back(nums[level]); helper(res, tmp, nums, level + 1); tmp.pop_back(); helper(res, tmp, nums, level + 1); } vector<vector<int>> subsets(vector<int>& nums) { vector<vector<int> > res; vector<int> tmp; helper(res, tmp, nums, 0); return res; } -
考虑层序遍历求解,每次加入一个元素就扩充res的长度,直到所有元素添加完毕
class Solution { public: vector<vector<int>> subsets(vector<int>& nums) { vector<vector<int> > res(1); for(int i=0;i<nums.size();i++){ int cnt=res.size(); for(int j=0;j<cnt;j++){ vector<int> tmp=res[j]; tmp.push_back(nums[i]); res.push_back(tmp); } } return res; } }; -
二进制位运算解法
class Solution {
public:
    vector<vector<int>> subsets(vector<int>& nums) {
        int S = nums.size();
        int N = 1 << S;
        vector<vector<int> > res;
        for (int i = 0; i < N; ++i) {
            vector<int> v;
            for (int j = 0; j < S; ++j)
                if (i & (1 << j))
                    v.push_back(nums[j]);
            res.push_back(v);
        }
        return res;
    }
};
基础算法问题的 Time Complexity
O(1) 极少
O(logn) 几乎都是二分法
O(n) 遍历
O(nlogn) 一般都需要排序
O(n²) 数组、枚举、动态规划
O(n^3)数组、枚举、动态规划
O(2^n) 与组合有关的搜索
O(n!) 与排列有关的搜索
二分法binary search的思想
二分法中的循环仅仅是为了缩小范围,而不是获得结果,二分法的核心就是将答案的范围缩小。
** 比O(n)更优的时间复杂度几乎只能是O(logn)的二分法**。
T(n) = T(n/2) + O(1) = O(logn)
通过O(1)的时间把规模为n的问题变为n/2=O(logn)
通过O(n)的时间把规模为n的问题变为n/2=O(n)
recursion or Loop?
一般使用loop,因为recursion涉及到了调用栈,占用内存较大,所以recursion不是常用解决办法。但如果recursion会更简单,可以先用recursion解决。
通用的二分法模板:
- while (start + 1 < end)
- 不用start < end 或 start <= end 或start + 1 <= end 是为了防止死循环,确保在只剩最后两个数时就开始做判断
- int mid = start + (end - start)/2
- 不用(start + end)/2是为了防止溢出,因为int型最大只有2^32-1
- A[mid] == , < , >
- 不管是否可以<=或>=,都先判断三种情况,以确保条件判断正确。
- A[start] , A[end] ? target
- first-pos-of-target时先判断start;last-pos时先判断end
- start = mid
- 不使用mid + 1是为了防止死循环(极端情况只有两个数时)
- end = mid
例题:binary-search
/first-or-last-pos-of-target
/search-a-2d-matrix
/search-insert-pos
/search-in-a-infinite-sorted-array
/search-a-rotated-sorted-array
/Find-peak-element
二叉树
T(n) = 2T(n/2) + O(1) = O(n)
T(n) = 2T(n/2) + O(n) = O(nlogn)
前中后序遍历
-
递归方法
typedef struct BiTNode{ TElemType data;//数据 struct BiTNode *lchild, *rchild;//左右孩子指针 } BiTNode, *BiTree; /*二叉树的前序遍历递归算法*/ void PreOrderTraverse(BiTree T) { if(T==NULL) return; printf("%c", T->data); /*显示结点数据,可以更改为其他对结点操作*/ PreOrderTraverse(T->lchild); /*再先序遍历左子树*/ PreOrderTraverse(T->rchild); /*最后先序遍历右子树*/ } /*二叉树的中序遍历递归算法*/ void InOrderTraverse(BiTree T) { if(T==NULL) return; InOrderTraverse(T->lchild); /*中序遍历左子树*/ printf("%c", T->data); /*显示结点数据,可以更改为其他对结点操作*/ InOrderTraverse(T->rchild); /*最后中序遍历右子树*/ } /*二叉树的后序遍历递归算法*/ void PostOrderTraverse(BiTree T) { if(T==NULL) return; PostOrderTraverse(T->lchild); /*先后序遍历左子树*/ PostOrderTraverse(T->rchild); /*再后续遍历右子树*/ printf("%c", T->data); /*显示结点数据,可以更改为其他对结点操作*/ } -
非递归方法-利用栈进行遍历
前序
栈S; p= root; while(p || S不空){ while(p){ 访问p节点; p的右子树入S; p = p的左子树; } p = S栈顶弹出; }vector<int> preorderTraversal(TreeNode* root) { stack<TreeNode*> S; vector<int> v; TreeNode* rt = root; while(rt || S.size()){ while(rt){ S.push(rt->right); v.push_back(rt->val); rt=rt->left; } rt=S.top();S.pop(); } return v; }后序
栈S; p= root; while(p || S不空){ while(p){ 访问p节点; p的左子树入S; p = p的右子树; } p = S栈顶弹出; } 结果序列逆序;vector<int> postorderTraversal(TreeNode* root) { stack<TreeNode*> S; vector<int> v; TreeNode* rt = root; while(rt || S.size()){ while(rt){ S.push(rt->left); v.push_back(rt->val); rt=rt->right; } rt=S.top();S.pop(); } reverse(v.begin(),v.end()); return v; }中序
栈S; p= root; while(p || S不空){ while(p){ p入S; p = p的左子树; } p = S.top 出栈; 访问p; p = p的右子树; }vector<int> inorderTraversal(TreeNode* root) { stack<TreeNode*> S; vector<int> v; TreeNode* rt = root; while(rt || S.size()){ while(rt){ S.push(rt); rt=rt->left; } rt=S.top();S.pop(); v.push_back(rt->val); rt=rt->right; } return v; }
层次遍历(BFS-Queue)
typedef struct Node{						//定义二叉链
	struct Node *lchild;					//指向左孩子节点
	char data;								//数据元素
	struct Node *rchild;					//指向右孩子节点
}BTNode;									//struct Node 的别名

typedef struct Quene{						//定义顺序队
	int front;								//队头指针
	BTNode *data[MaxSize];					//存放队中元素
	int rear;								//队尾指针
}SqQueue; 									//struct Queue 的别名

//初始化队列
void initQueue(SqQueue * &q){
	q=(SqQueue *)malloc(sizeof(SqQueue));	//分配一个空间
	q->front=q->rear=-1;					//置 -1
}

//判断队列是否为空
bool emptyQueue(SqQueue * &q){
	if(q->front==q->rear){					//首指针和尾指针相等,说明为空
		return true;						//返回真
	}
	else{
		return false;						//返回假
	}
}

//进队列
bool enQueue(SqQueue * &q,BTNode * &BT){
	if(q->rear==MaxSize-1){					//判断队列是否满了
		return false;						//返回假
	}
	q->rear++;								//头指针加 1
	q->data[q->rear]=BT;					//传值
	return true;							//返回真
}

//出队列
bool deQueue(SqQueue * &q,BTNode * &BT){
	if(q->front==q->rear){					//判断是否空了
		return false;						//返回假
	}
	q->front++;								//尾指针加 1
	BT=q->data[q->front];					//取值
	return true;							//返回真
}

void levelOrder(BTNode * &BT){
	SqQueue *q;									//定义队列
	initQueue(q);								//初始化队列
	if(BT!=NULL){
		enQueue(q,BT);							//根节点指针进队列
	}
	while(emptyQueue(q)!=true){					//队不为空循环
		deQueue(q,BT);							//出队时的节点
		printf("%c",BT->data);					//输出节点存储的值
		if(BT->lchild!=NULL){					//有左孩子时将该节点进队列
			enQueue(q,BT->lchild);
		}
		if(BT->rchild!=NULL){					//有右孩子时将该节点进队列
			enQueue(q,BT->rchild);
		}										//一层一层的把节点存入队列
	} 											//当没有孩子节点时就不再循环
}
maxlength/minlength of B-tree : Traverse or Divide-Conquer
-
分治的方法优于遍历的方法
这是因为分治不会一直传结果,而遍历会把结果当成参数传下去,造成冗余。
动态规划
链表 linked-list
声明:
//
struct CacheNode {
    int key;
    int value;
    CacheNode *pre, *next;
    CacheNode(int key, int value):key(key), value(value), pre(NULL), next(NULL){}
};
Dummy Node
ListNode* result = new ListNode(0);
result->next = head;
两两翻转链表
主体:
while (p != NULL && p->next != NULL){
    q = p->next;
    p->next = q->next;
    q->next = p; //q->next = pre->next;
    pre->next = q;
    pre = p;
    p = p->next;
}
k个一组翻转链表
主体:
for (i = 0; i < loopNum; i++){
    for (j = 0; j < k-1; j++){
        if (p != NULL && p->next != NULL){
            q = p->next;
            p->next = q->next;
            q->next = pre->next;
            pre->next = q;
        }
     }
     pre = p;
     p = p->next;
}
全部:
class Solution {
public:
    ListNode* reverseKGroup(ListNode* head, int k) {
        if (head == NULL || k <= 0){
            return nullptr;
        }
        int count = 0;

        ListNode* cur = head;

        while (cur != NULL){
            count++;
            cur = cur->next;
        }

        int loopNum = count/k;
        int i, j;
        ListNode* result = new ListNode(0);
        result->next = head;
        ListNode* pre = result;
        ListNode* p = head;
        ListNode* q = head;
        for (i = 0; i < loopNum; i++){
            for (j = 0; j < k-1; j++){
                if (p != NULL && p->next != NULL){
                    q = p->next;
                    p->next = q->next;
                    q->next = pre->next;
                    pre->next = q;
                    }
            }
            pre = p;
            p = p->next;
        }

        return result->next;
    }
};
快慢指针
删除倒数第k个节点
数组 array
声明:
//type arrayname[arraysize];
int array[10] = {1000.0, 2.0, 3.4, 7.0, 50.0};
//vector容器
vector<int> a1;
vector<int> a2(2, -1);  //2个int元素值均初始化为-1
vector<int> a3(10);  //10个int元素值均初始化为0
vector<string> svec1 ={"the", "three", "kingdoms"};
vector<string> svec2(10);  //10个string对象初始化为空

v.push_back(temp);  //向vector中添加元素
v.empty();  //检查是否为空
v.capacity();  //返回当前vector中最大可以存储数据的容量
v.begin();v.end();  //
v.size();  //返回v中元素的个数
v[n];  //获取v中第n个元素
//特别注意:对于一个空的vector,不能使用下标向其中添加元素。只能使用push_back. 只能对确知已存在的元素执行下标操作。
vector<int>::iterator it;  //it是能读写的vector中的元素
string::iterator it1;  //it1是能读写的string对象中的字符

//字符串
char string[10] = {'h', 'e', 'l', 'l', 'o','\0'};
char string2[] = {"hello"};

strcpy(s1,s2);  //复制s2到s1
strcat(s1,s2);  //连接s2到s1末尾
strlen(s1);  //长度
strcmp(s1,s2);  //比较
双指针问题(Two Sum)
-
two sum可以用hash做,也可以用相向双指针做
-
three-sum/two-sum-closest 用相向双指针
-
partition-array 思想和快排类似,典型题可以分为两部分和三部分
while (i <= j) {
    while (i <= j && a[i] < target) {
	    i++;
      }
    while (i <= j && a[j] >= target) {
  	    j--;
    }
      if (i <=j) {
        swap(a[i], a[j]);
  	    i++;
        j--;
      }
}
return j+1;
SubArray
- best time to buy and sell stock/数飞机/Maximum Array
- prefix sum问题
Sorted Array
-
merge-two-sorted-array
- 一是可以开辟新空间的
- 二是存在同一个数组中的,反向比较
-
两个有序数组中的中位数/第k个数
-
一是O(m+n)的双指针寻找
-
二是O(logn)的二分法,两个数组的前k/2
比较nums1[k/2]和nums2[k/2]的大小
    小的那个数组count+k/2;
    k = k - k/2;
直到取到第k个
-
-
数组内积(点乘)
-
intersection-可以用哈希
数据结构
Queue == BFS
支持操作:O(1) push; O(1) pop; O(1) top
Stack == DFS
支持操作:O(1) push; O(1) pop; O(1) top
数据结构实现题/非递归问题(DFS问题)/单调栈问题
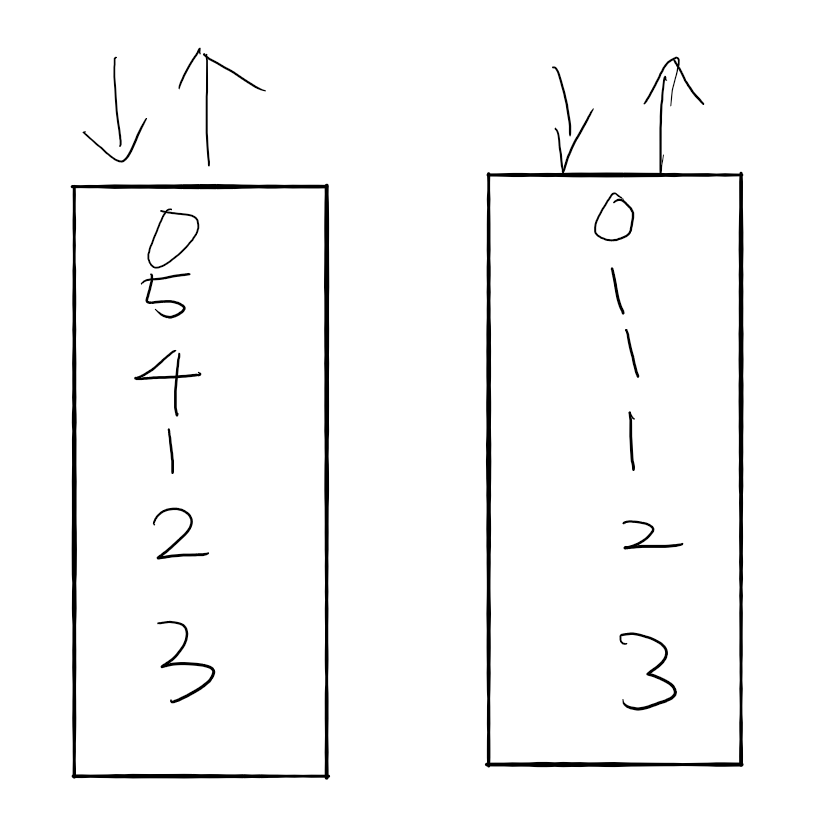
例题:min stack
构造一个存放最小值的栈,同步更新
例题:largest rectangle in histogram
例题:两个栈做一个队列两个队列做一个栈
HASH
实现原理,减小冲突: array+list形式;多个hash function;
rehashing很复杂所以要避免!
支持操作:O(1) insert; O(1) find; O(1) delete
构造:
// 定义一个map对象
map<int, string> mapStudent;
// 第一种 用insert函數插入
pairmapStudent.insert(pair<int, string>(000, "student_zero"));
// 第二种 用insert函数插入value_type数据
mapStudent.insert(map<int, string>::value_type(001, "student_one"));
// 第三种 用"array"方式插入
mapStudent[123] = "student_first";
mapStudent[456] = "student_second";
查找:
map<int,CacheNode*>::iterator it = mp.find(key);
// find 返回迭代器指向当前查找元素的位置否则返回map::end()位置
iter = mapStudent.find("123");
if(iter != mapStudent.end())
    cout<<"Find, the value is"<<iter->second<<endl;
else
    cout<<"Do not Find"<<endl;
删除:
//迭代器刪除
iter = mapStudent.find("123");
mapStudent.erase(iter);
//用关键字刪除
int n = mapStudent.erase("123");
//如果刪除了會返回1,否則返回0
//用迭代器范围刪除 : 把整个map清空
mapStudent.erase(mapStudent.begin(), mapStudent.end());
//等同于mapStudent.clear()
其他基本函数:
 C++ maps是一种关联式容器,包含“关键字/值”对

 begin()         返回指向map头部的迭代器
 empty()         如果map为空则返回true
 end()           返回指向map末尾的迭代器
 size()          返回map中元素的个数
 count()         返回指定元素出现的次数

 equal_range()   返回特殊条目的迭代器对
 get_allocator() 返回map的配置器
 key_comp()      返回比较元素key的函数
 lower_bound()   返回键值>=给定元素的第一个位置
 max_size()      返回可以容纳的最大元素个数
 rbegin()        返回一个指向map尾部的逆向迭代器
 rend()          返回一个指向map头部的逆向迭代器
 swap()           交换两个map
 upper_bound()    返回键值>给定元素的第一个位置
 value_comp()     返回比较元素value的函数
Hash Table/Hash Map/Hash Set的区别是什么?
hash table支持多线程
多线程的producer/ consumer模式
LRU-cache算法
hashmap<key, DoublyListNode>;
Heap == Priority Queue
支持操作:O(logn) add; O(logn) remove; O(1) min or max
例题:ugly-number
O(n)
heap + hashmap O(nlogn)
queue<long> Q;
vector<long> primes;
primes = {3,5,7};
hashmap<long,Boolean> mp;
for (int i = 0; i < 3; i++){
    Q.add(primes[i]);
    mp.put(primes[i],true);
}
long number = long.value?;
for (int i = 0; i < n; i++){
    number = Q.?();
    for (int j = 0; j < 3; j++){
        if (!mp.containskey(primes[j]*number){
            Q.add(number*primes[j]);
            mp.put(number*primes[j],true);
        }
    }
}
return number;